Компания OpenAI объявила о скором внедрении важного обновления в работу своих популярных моделей ChatGPT и Codex. В ближайшие недели генерируемые сервисами тексты начнут получать специальную невидимую маркировку, позволяющую однозначно определять их искусственное происхождение. Подобный шаг продиктован строгими нормами Закона ЕС об искусственном интеллекте, требующего, чтобы результаты работы генеративных моделей оставались легко распознаваемыми для защиты информационного пространства. Для реализации этого правила разработчики задействуют фирменную технологию под названием textGrain.
Уникальность этого метода заключается в том, что он совершенно не искажает восприятие материала человеком. Система не внедряет в итоговые ответы скрытые символы, невидимые пробелы или нестандартные знаки препинания. Вместо этого алгоритм незаметно для читателя корректирует математическую вероятность выбора последующих слов и их частей на этапе генерации. В результате в структуре текста формируется тонкая статистическая закономерность, которую рядовой пользователь не заметит, но без труда зафиксирует специализированный детектор.
Новая защита не является абсолютным решением и эффективна далеко не в любой ситуации. Результативность анализа напрямую зависит от объема и стилистики предоставленного контента. Например, лаконичные ответы распознаются с большим трудом, а при проверке узкоспециализированных или строго формализованных материалов, таких как математические тексты, точность работы детектора заметно снижается. Внутренние тесты показали, что при минимальном уровне ложных срабатываний в 1% система стабильно находит скрытый водяной знак в 80% текстов объемом около 200 токенов и достигает эффективности в 95% на материалах длиной от 400 токенов.
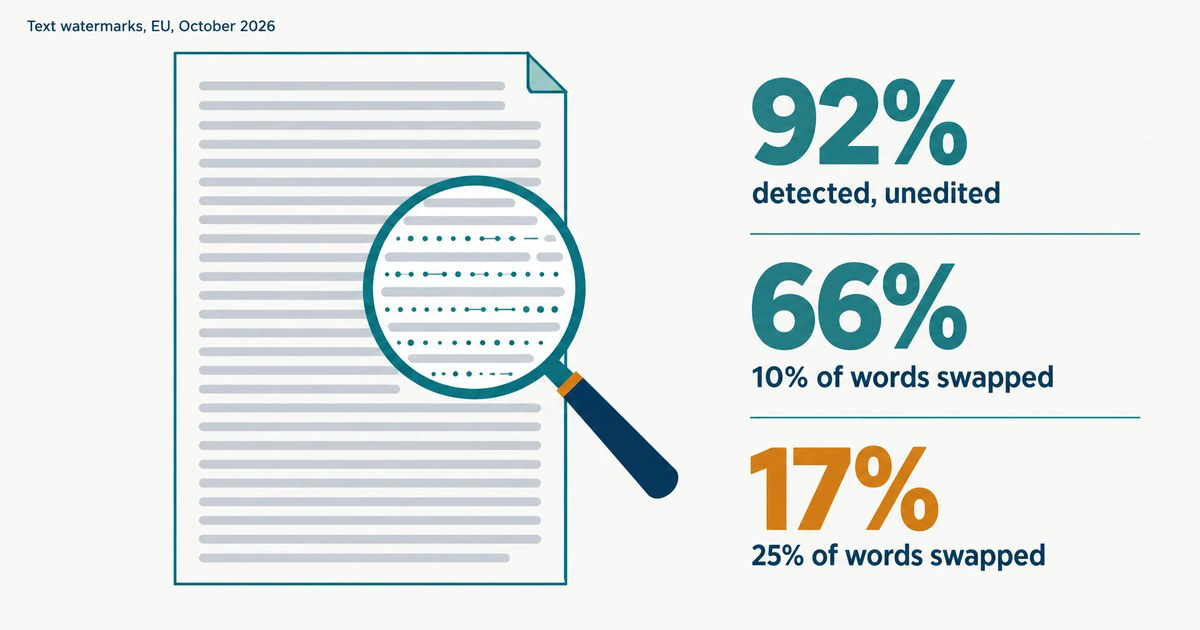
Главной уязвимостью предложенного метода остается последующее редактирование готового материала человеком. Эксперименты с текстами на 400 токенов наглядно продемонстрировали, что даже поверхностная корректура способна обойти защиту. Так, простая замена всего 10% слов близкими по смыслу синонимами снижает вероятность обнаружения машинного следа с первоначальных 92% до 66%. Если же пользователь перефразирует хотя бы четверть исходного текста, эффективность сканирования падает до критических 17%, делая маркировку практически бесполезной.
На старте проекта доступ к инструментам верификации получат лишь аккредитованные исследовательские центры и профильные организации, однако в долгосрочной перспективе планируется сделать технологию textGrain доступной для сторонних разработчиков. При этом клиенты, использующие решения через API по всему миру, смогут самостоятельно активировать данную функцию для поддерживаемых моделей в ручном режиме, поскольку по умолчанию в интерфейсе программирования она останется выключенной.